OpenAI 的 Agents API 与 Decisions API 对比:什么时候该用哪一个(以及如何塞进你的营销技术栈)
目录
OpenAI 这个秋天连发两个 API,远看像近亲,干的却是截然不同的活。Agents API 在 2026 年 9 月 10 日进入公开测试版;Decisions API 三周后以限量预览的形式在 9 月 29 日的 DevDay 上亮相。只要你在搭建营销自动化——活动质检(campaign QA,投放前逐条广告过审)、潜客路由(lead routing,把表单线索分发给不同销售队列)、UGC 内容审核、广告创意挑选——你现在多了两种新形状的工具可以接进去。这一篇是我连续把玩一周之后的拆解,以及这两个 API 在真实营销栈里的位置。
一句话区分
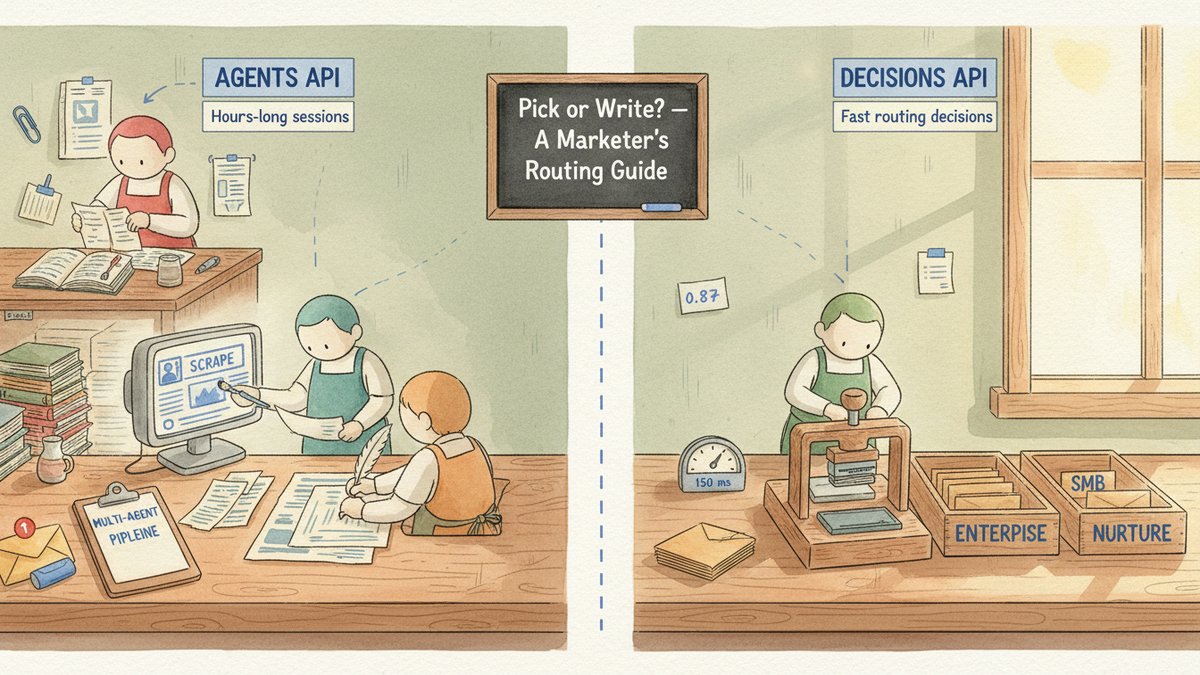
Agents API 跑的是长链路、多步骤的云端任务;Decisions API 在你定义的有限答案集合里挑一个。如果你的活需要写一段话、调一次工具、或者起一个子代理——这是 Agents API。如果你的活只需要一个标签、一个队列、一个 yes/no——这是 Decisions API。剩下的都是细节。
Agents API 到底给你什么
Agents API 本质上是 OpenAI 的"让我们替你跑 harness(智能体执行框架,负责上下文管理、工具调度、流程串联)"。底层就是驱动 ChatGPT Work 和 Codex 本身的同一套 Codex harness,只不过包成了一个你可以控制的 API 调用。你提供任务、模型、工具和环境;OpenAI 处理上下文管理、自动压缩、工具检索(tool search)、程序化工具调用(programmatic tool calling)、并行子代理。
对营销人来说有三块最实在:
- 可以跑几个小时,不是几分钟。 会话接近模型上下文窗口上限时会自动做上下文压缩(compaction)。一场扫 50 个竞品站点、逐站总结、再吐一份 PDF 的情报任务,可以在某个周二下午无人值守地跑完,然后 Slack 通知你。
- 子代理可以并行。 一次 Agents API 调用可以把任务拆给多个子代理(每个有自己独立的上下文),最后合并结果。这跟我之前在 n8n 里跑的多代理竞品情报流水线是同一种形状——只不过现在编排由 OpenAI 来做。
- 沙箱(sandbox)可以自选。 OpenAI 自托管沙箱、自己部署、或者用合作伙伴(Blaxel、Cloudflare、Daytona、DigitalOcean、E2B、Modal、Oracle、Runloop、Vercel)。对处理客户 PII(个人可识别信息)或自有广告账户数据的营销人来说,自托管在自己 VPC(虚拟私有云)里把"数据落在哪里"这件事直接讲清楚。
定价这块很简单:Agents API 本身不额外收费。你按使用的 token 和工具调用结算,按标准模型费率计费。对任何已经在跑 GPT-6 Sol 或 GPT-6 Astra 的人来说,Agents API 几乎就是免费升级。
我从发布稿里第一个想抄下来的代码块就是多代理那段:
json"agent": {
  "model": "gpt-6-astra",
  "multi_agent": {
    "enabled": true,
    "max_concurrent_subagents": 3
  }
}
加这三行,就把"一个聊天机器人串行读十个竞品首页"变成"一个协调者把活拆成三路并发"。
Decisions API 到底给你什么
Decisions API 是相反的形状。你定义问题和你能接受的有限答案集合;模型返回其中一个,外加一个置信度分数。OpenAI 的发布材料把底层模型写成 Luna,但没有公布版本化的模型 ID、接口路径或费率表——OpenAI 说定价要等全面发布时才会公布。任何第三方给出的"每次决策 X 美元"都当推断看。
确定的事是:它在约 150 毫秒内返回一个受限答案,输入支持文本或图像,是为分类、路由、以及"这个代理下一步该干什么"这类决策设计的。跟这个月早些时候 #195 写过的 TypeSafe Jev 对比,区别真实但很小——两个 API 都会返回带概率的强类型答案。Jev 把 schema(数据结构契约)暴露成原语(Choice、Score、Noul);Decisions API 把它暴露成你自己定义的答案集合。如果你已经在 OpenAI 生态里,Decisions API 是显然的选择;如果你想让 schema 本身就是契约,Jev 是更严谨的选择。
对营销人来说最关键的形状是路由决策。一张客服工单进来:该进五个队列里的哪一个?一个新潜客提交了 demo 表单:分给 SMB(中小企业)自助、还是企业销售、还是培育序列?一条 UGC 评论落在你的 Meta 广告下面:保留、隐藏、还是升级人工审?这三件事全是 Decisions API 的活。它们都不需要 600 个 token 的长文——它们需要一个标签加一个置信度。
营销栈里的头对头对比
| 任务 | Agents API | Decisions API |
|---|---|---|
| 每天扫 30 个竞品的 Meta 广告库 → Slack 简报 | 适合——多代理研究、长会话、文件输出 | 不适合——形状错了,需要综合而不是标签 |
| 入站 demo 表单 → 路由到 SMB / 企业 / 培育 | 杀鸡用牛刀——只需要一个路由标签 | 适合——定义三个队列,传入表单数据,拿答案 |
| UGC 评论审核:安全 / 复核 / 下架 | 杀鸡用牛刀——不需要工具调用或上下文压缩 | 适合——图像加文本进,三个标签之一出 |
| 投放前活动质检(12 条规则的评分卡,跑在 Meta 广告组上) | 适合——要读 200 条广告、逐条打分、再写修复清单 | 部分适合——能打分,但写不了修复清单 |
| A/B 测试赢家挑选:ship_a / ship_b / wait | 适合(如果你还想让代理顺手写下轮的简报) | 适合(如果你只要那个选择加置信度) |
| 每天扫 9 个 subreddit → Slack 摘要 | 适合——需要跨帖综合、引用、排版 | 不适合——形状错了 |
第三行是我最兴奋的。决策类 API 把审核这件事从"开个 GPT-6 对话框,对每条评论精心写提示词"变成"送进图像和评论文本,拿到 safe / review / remove 三个标签之一,置信度低时降级人工"。这把原本需要一个全职外包的审核队列,压缩到营销人在内部就能跑的程度——而且它跟我已经跑了两年多的 UGC 评论审核分流工作流天然契合。
一个必须讲的提醒:Decisions API 不解决什么
受限答案空间让集成变简单——调用方知道所有允许的值、能拒绝未知答案、给每个分支挂不同的权限、在置信度低时降级人工。但受限模型仍然可能挑出错的合法答案,仍然会继承你分类标签里的偏见,仍然会对你没给过的上下文瞎编。Decisions API 不是合规官,它是一个拿着评分表的高速打字员。任何"答错代价大于节省时间"的场景,都要把人留在回路里。
我目前怎么把两个 API 拼进栈
过去一周,我在原本用 n8n + Claude 的位置跑了一个 Agents API 小任务:每天扫三个竞品站、三个竞品广告库、三个竞品 LinkedIn 主页,简报在当地时间上午 9 点前落 Slack。它用一次 Agents API 调用加一个 multi_agent 块,替掉了 n8n 里四个独立的工作流。token 成本是唯一真正的开销。
Decisions API 这边,我打算等 OpenAI 公布费率表再动手。它的形状正是我想要用来做入站潜客路由的——我今天在 Make.com 里用 Gemini 当大脑跑一个接近的版本(见我之前写的 4 代理潜客路由)——只要定价合理,Decisions API 能显著压低延迟。如果落在 Luna 那个 $0.10–$0.30 每百万 token 的区间,我打算把一半路由量切过去。
路由原则
任务里要调工具、要写文件、要多步推理、要有子代理并行——用 Agents API。任务里有固定答案集合、答错代价很低——用 Decisions API。当你分不清一个任务属于谁,问一个问题就够:"这个任务是 写 东西,还是 挑 东西?"写,是 Agents API;挑,是 Decisions API。这一条过滤器在表里所有任务上都没让我多想。
两个 API 都还很新。Agents API 在公开测试版里快速迭代;Decisions API 在限量预览里,还没有公布的费率表。把 Agents API 当作"非客户接触面生产可用",把 Decisions API 当作"本周值得原型验证的开发者预览"——这样一旦全面发布,你就排在最前面。