DeepSeek 说:AI 工作的单位不该再是「会话」——这对营销人的技术栈意味着什么
目录
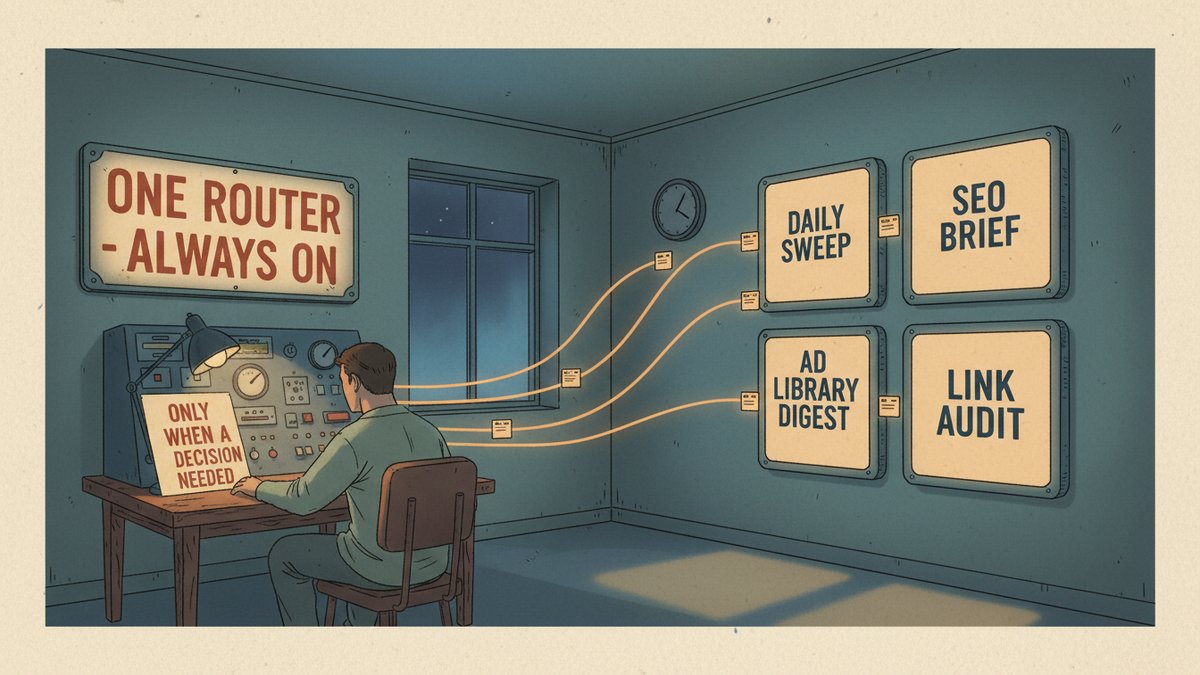
每周一,我都会打开同样四样东西:一个 Reddit 购买意图监控、一个关键词追踪、一个竞品广告库监控、一个内链审计。它们各自是一个对话、各自一个智能体、各自一个标签页,而且都只在我记得打开它的时候才存在。碰上我忘了看 Reddit 那一项的那一周,整周的购买意图帖子就这么刷过去了。这就是大多数人所谓「AI 赋能营销」的真实状态:不是一个在干活的智能体,而是四个需要我盯着的水龙头。
2026 年 10 月 31 日,DeepSeek 的 Harness 团队发了一篇几乎正对这个缺口的文章,还附上了一个 MIT 授权的原型:**会话不应该再是智能体工作的基本单位。**不是模型,不是提示词,是会话。他们的设计是:让一个常驻智能体统管全局,把工作扇出给多个并行隔离的 worker,并且只有在真的需要人做决定时,它才开口。
DeepSeek 到底发布了什么
同一天两个东西。一篇设计文章——《Exploring Super-agent Design: Towards a More Autonomous Agent System》(《超级智能体设计探索:走向更自主的智能体系统》),作者是 Yujia Qiao(乔宇佳),发在团队的微信公众号上——以及 GitHub 上 MIT 授权的 dsh-superagent-prototype 仓库。
README 对它的描述是:「一个面向单个 GitHub 仓库的主动式编码智能体(proactive coding agent),以 DeepSeek Harness 插件包的形式打包。它监听 GitHub,也可以选择监听飞书。当某个被允许的人向它派活时,它会开一个工作项(work item),在自己的智能体会话和目录里干活,然后在原来的对话里回复,比如给你开一个 PR。一个网页面板显示哪些事需要人来看。」
这份 README 里有两句话比本文其他内容都重要:「仅供参考的研究原型,不是 DeepSeek 的官方产品」,以及「文章中讨论的某些设计是未来开发方向,并未在这个原型中实现」。这是为公开发布做过适配的研究代码,团队自己也把跑分结果称为「初步参考」。
拓扑结构:一个做不了活的 router
核心是两层,而上面那层是刻意掏空的。
Router 是一个常驻会话,掌管所有人类入口——聊天、GitHub 评论、CI 结果——并决定哪个请求交给谁。它不干活,设计文章甚至说它可能连 Bash 工具都没有。路由本身很便宜,轻量模型就够。
Worker 是带全套工具的隔离会话,一件工作一个,各自在自己的目录里并行跑。它们从不直接跟人对话,而是把结果汇报给 Router,由 Router 代为回复,所以你永远不会同时看到四个智能体在跟你讲话。工作是以事件而不是提示词的形式到达的,先用代码过滤一遍才轮到模型;每个 Worker 订阅自己关心的线程,所以某条 PR 下的后续消息能直接送到它那儿,不经过 Router。
这就是整个设计的缩影。常见的「主智能体带子智能体」拓扑,让主智能体负责拆解任务,于是主智能体成了瓶颈。DeepSeek 的 Router 从不拆解任务。把这一层保持薄,它就不会变成天花板。
他们自己的测试结果
DeepSeek 用四种配置,对抗一条合成的群聊与 GitHub CI 消息流——每轮大约 300 条消息,其中约 20 条是真实的工作请求,每种配置跑 5 轮。测试里把写代码换成了一个只消耗时间的工具,所以它测的是调度,不是产出质量。
| 配置 | 结果 |
|---|---|
| 超级智能体 | p50 12.4 分钟,p95 15.7 分钟 |
| 单会话 + 子智能体工具,中性提示词 | 5 次全部没有分派;p95 29.5 分钟 |
| 单会话,提示词明确要求倾向分派 | 5 次里有 4 次分派了;仍然更慢 |
| 超级智能体,但后续消息不直接路由给 Worker | 完成时间相同;Router 决策多约 30%;缓存 token 读取从 2330 万涨到 3180 万 |
| Router 负载约 1 个触发/分钟 | 每次决策推理 6.4 秒 |
| Router 负载约 40 个触发/分钟 | 每次决策 1.6 秒,平均批大小 2.8 |
第二行值得读两遍。用中性提示词时,模型所有活儿都自己干,并且不断被新消息打断;改写成「倾向分派」后 5 次里有 4 次分了,第 5 次它判断这活儿太小不值得交出去,于是拖出了长尾。超级智能体把这个判断彻底从提示词里拿掉了——因为 Router 根本没法干活。最后两行则解释了为什么单个 Router 能扩展:负载越高,批量处理越能把路由成本摊薄,Router 越忙,单次决策反而越便宜。
最值得抄的部分:把注意力当预算
philosophy 文档第一行就是整个发布里最值得引用的一句:**尽可能少占用人的注意力,尽可能多地交付价值。**项目的每一部分都按它消耗的注意力来评判——一条消息、一次通知、一个问题、面板上的一个元素、一段文档,每一样都要回报超过它的成本,否则就被删掉。
由它推导出来的规则短到可以直接照搬:只在被要求时行动,或者在团队写下的规则允许时行动,而没人要求的工作一开始只记录它本来会做了什么;只在需要人行动、或者人能用上结果时才说话;一次只问一个具体问题;按影响停下来,而不是按努力停下来;如实汇报。面板只显示需要人处理的事。而给运维的人还有一句:「不要用它来生产量。」
授权文档把这套哲学变成了你即使不部署这个项目也能用的机制。接受模式(accept mode)有三档:off、observe(默认)和 auto。在 observe 模式下,模型判定「值得接受」的候选只会被记录成「本来会接受」,实际并不接受,而明确指派的请求在任何模式下都照常工作。所有规则、接受模式以及每个来源的策略会被哈希成一个策略版本(policy version),每件工作都记录下自己是在哪个版本下被接受的,于是规则放松不会当场掐掉正在跑的活,却能在重新校验时撤销一份授权(Mandate)。机器人则完全不能提出明确请求。
如果你已经在跑定时智能体——我会拿它去套我的每日 Reddit 监控智能体——那么 observe 模式就是你周一该做的功课:把主动这条路径以只记录的方式跑一周,读一读它本来会做什么,然后再放宽。
一个营销人真正会拿它做什么
原型偏开发者、限定在单个 GitHub 仓库。但这个拓扑可以移植,而且它逼你回答的问题恰恰是问题本身。
一个常驻 router,多个并行 worker。router 盯住各个来源——Reddit、某个论坛、Slack 频道、定时任务——然后派活;它干不了活,所以它永远不会被诱惑着把一个活儿草草做完来省一次往返。worker 则是每个活儿一个隔离会话:每日购买意图扫描、一批 200 个关键词的 SEO brief(内容简报)、竞品广告库摘要、1000 个 URL 的内链审计。
有两件事会变。第一,路由很便宜,所以只有 worker 需要强模型,而且你可以按活儿分别挑——DeepSeek 自己的答案应该是 V4.1 Flash,因为 worker 恰好就是它当初定价瞄准的那种活儿:量大、输出有界、上下文重复且吃缓存。这个项目原则上与模型无关,所以这个选择是你的。
第二点更重要:你拿到了运行「安静型自动化」的许可,而这恰恰是大多数团队始终批不下来的事,因为人们真正怕的失败模式不是答案错了,而是每天四十条通知。「只有在需要人行动、或者人能用上结果时才说话」这句话,才让一个常驻的营销智能体能被一个不想变成监控大屏的人批准。这也是我目前见到的、对已经在卖给营销人的那些常驻智能体产品最清晰的架构级回答——ChatGPT Work、Lindy AI——因为 DeepSeek 发布的是这件事的形状,而不是又一个订阅按钮。
最强的反驳
让它保持安静的那套权限机制,和给它一个 shell 的,是同一套。
执行文档写得很清楚:worker 会话以运维者的操作系统用户身份、不经审批地运行命令;被禁用的命令清单和目录包装「建立的是默认行为,不是安全边界。一个 worker 仍然可以用绝对路径执行程序」。自动合并对智能体账号默认关闭,默认指令也只允许它对改动行数少于 200 的 PR 使用,且要求审批覆盖 head commit(最新提交)。这套默认值是合理的,但它不是沙箱。
设计文章在剩下的问题上更直白:除非这些问题被解决,超级智能体只能在很小的一块可信范围内运行;而一个从外部事件取数、又能连到握着凭据的设备的云端循环,天然暴露在提示词注入(prompt injection)之下。想想 worker 读了什么——issue 正文、PR 评论、README、聊天消息,全是别人写的文字,全都可以夹带指令。
再说跑分:合成的、厂商自己披露的,测的是调度而不是产出质量。更快地路由到一个错误的产物,不算赢。到 11 月初,还没有任何 DeepSeek 之外的人报告过在真实仓库上跑过这个原型——仓库在 11 月 1 日已经有 4300 个 GitHub star,但我去看的时候,那条 Hacker News 提交只有 9 分、零评论。
还有营销人专属的那一条:这套东西的一切都是仓库、shell 和 git 身份。营销人没有 PR。从这套设计到营销技术栈的翻译不是移植,是重做,而且重做是你自己的活儿。
我最后的判断
去读这个设计。但暂时不要装。
这就是 README 自己的姿态,对营销人来说也是诚实的姿态。但要读,因为真正的贡献不是 router 加 worker 的拆分——router 加 worker、事件队列、工单化的工作都是熟悉的零件,你在大多数多智能体框架里都能找到同样的形状。新的是:**安静成了一等结果。**一个只显示需要人处理的事的面板,一个干活时保持沉默的智能体,一个记录「它本来会做什么」而不是直接去做的 observe 模式。这就是策略层,而策略层恰恰是智能体技术栈里你事后补不上的那一部分。
这套设计还从侧面论证了一件事:我们大多数营销智能体技术栈,从一开始形状就错了。我们围绕对话来搭,因为我们拿到手的工具就是对话。而一个 router、一队 worker、一套严格的打扰策略,本该从一开始就是常驻营销智能体的样子——而你真正动手画出这个形状的那一刻,也就是你不再问「下一个该订阅哪个工具」的那一刻。